 Orakul
«Почему конкурент выше нас?» — вопрос, который клиент задаёт на каждом втором созвоне. Честный ответ на него требует контрастного анализа: открыть топ по запросу, выписать, что есть у каждого конкурента, сверить со страницей клиента. Это около трёх часов на один запрос, поэтому руками так проверяют один-два запроса из десятков, которые стоило бы проверить. Всё остальное закрывают сервисы «анализа релевантности», которые выдают одно число и не говорят, что именно дописать. В этой статье — агент, который по адресу страницы и запросу возвращает список правок, отсортированный по тому, у скольких конкурентов из топа это уже есть. И который отказывается давать правки, когда сравнивать нечего. Настройка проверена на живом магазине — результаты ниже.
Что этот агент должен реально делать
Одна задача: страница клиента и поисковый запрос на входе, список правок на выходе. Первой строкой идёт то, что закрыли девять конкурентов из десяти, а у клиента нет, последней — то, что есть у четверых. По дороге агент считает пять вещей:
- Покрытие подтем. На какие вопросы отвечает каждая страница топа, сведённые в чек-лист с частотой.
- Факты и сущности. Цены, сроки, количества, названия и характеристики, которые приводит большинство в топе и не приводит клиент. Самое дешёвое в подсчёте и самое конкретное на выходе.
- Прямой ответ. Отвечает ли страница на сам запрос в первых 500 знаках.
- Свежесть. Медианная дата обновления в топе против клиентской.
- Спрос. Сколько людей ищут эту фразу, чтобы отличить важную дыру от дыры в запросе, который никому не нужен.
Чего он делать не должен: выводить сводный балл, обещать позиции, давать правки, когда топ отвечает на другой вопрос, и придумывать спрос, если инструмент его не вернул. Решение, какие правки вносить и в каком порядке, остаётся за специалистом.
Почему здесь нет общей оценки релевантности
Привычные инструменты сводят ширину, глубину, BM25 и авторитет домена в один балл. Проблема в том, что модель ранжирования снаружи недоступна, и любой такой балл — предположение о её устройстве. Когда мы разбирали таблицу одного популярного сервиса, итоговая сортировка оказалась произведением процента по шкале 0–100 на вес BM25 в диапазоне 0,08–0,27, а ранговая корреляция этого порядка с реальными позициями — около 0,47. То есть порядок объяснял примерно пятую часть разброса. И даже точный балл не сказал бы, какое из слагаемых просело.
Здесь постановка другая: выдача — это уже готовая разметка. Вопрос не «оцени мою страницу», а «чего есть у тех, кто ранжируется, и нет у меня». Метрика контрастная — клиент против топа по конкретному запросу. Отсюда и название.
Как ставить задачу
Агенту нужны две вещи в тексте задания: адрес страницы клиента и поисковый запрос. Достаются они разными механизмами:
| Что | Как достаётся | Что это значит на практике |
|---|---|---|
| Адрес клиента | Первая ссылка в тексте задачи | Ставьте в задании ровно одну ссылку. |
| Поисковый запрос | Первая фраза в кавычках, затем фраза после слова «запрос», затем последняя строка | Берите запрос в кавычки и ставьте его первым закавыченным текстом. |
Формулировка, которая работает:
Сравни страницу https://example.com/seo-tbilisi с топом Google
по запросу "сео тбилиси" и скажи, чего на ней не хватает.Роутер: семь шагов
Контрастный анализ не помещается в один вызов модели, поэтому это роутер — роль, у которой вместо одной инструкции пронумерованный алгоритм. Как устроены роутеры в целом, разобрано в гайде «Как создать ИИ-агента. Аудит сайта». Вот шаги этого, как они выглядят в панели:
или Вордстат для русских запросов
Три шага-инструмента подряд запускаются одновременно: страница клиента, выдача и спрос приезжают параллельно, а не в очередь. Системный промпт роутера почти ничего не делает — его работа в том, чтобы донести адрес и запрос до последнего шага без искажений:
Ты — оркестратор контрастного анализа страницы. Твоя единственная
задача — без искажений передать через все шаги две вещи: адрес
страницы клиента и поисковый запрос, по которому идёт сравнение.

Сам анализ делают шаги-инструменты и субагенты. Не пиши собственных
выводов, не пересказывай результаты шагов и не дополняй их своими
соображениями.

Если в задании не удаётся найти адрес страницы или поисковый запрос —
скажи об этом сразу и не запускай шаги: без любого из двух сравнение
не имеет смысла._router, и фоновый режим обязателен. Без сегмента платформа не считает роль роутером: пропадает кеш по адресу, а вместо отчёта пользователь получает сырой лог «ШАГ 1… ШАГ 7». Сегмент проверяется целиком, между подчёркиваниями: contrast_analysis_router подходит. А семь шагов со скачиванием десятка страниц — это минуты, поэтому включите «Всегда выполнять в фоне»: агент сразу подтвердит задачу и пришлёт отчёт отдельным сообщением.Четыре субагента: у каждого одна работа
Можно было бы написать одну большую инструкцию «сравни страницу с топом». На практике модель, которой дали и сверку, и рекомендации, на середине таблицы переключается в режим советов и перестаёт проверять оставшиеся строки. Поэтому работа разложена на четыре роли.
Сборщик страниц топа
Обычный шаг-инструмент умеет открывать только первый адрес из задания, то есть страницу клиента. Пройти по десяти разным адресам может только субагент, который сам вызывает «Парсинг сайта». И сразу сжимает каждую страницу в выжимку: десять полных текстов дальше по цепочке просто не поместятся.
Ты — сборщик страниц конкурентов в конвейере контрастного анализа.
В контексте есть выдача Google по запросу: позиции, домены и адреса
страниц.

Для КАЖДОГО результата выдачи вызови fetch_url_content по адресу
страницы (не по домену) и разбери, что на ней есть.

Не пересказывай страницы целиком и не цитируй их длинными кусками.
Твой ответ читает следующий субагент, и десять полных текстов в него
просто не поместятся. По каждой странице верни ровно такой блок:

ПОЗИЦИЯ N — адрес
Заголовок: H1 страницы
Тип: коммерческая / информационная / каталог / карточка / другое
Отвечает на: 5–12 подтем одной строкой каждая, максимально
  конкретно — не «про цены», а «сколько стоит и что входит в
  стоимость»; не «про сроки», а «через сколько месяцев ждать
  результат». Формулируй как вопрос клиента, а не как раздел сайта.
Факты и числа: конкретика, которую страница приводит — цены, сроки,
  количества, названия инструментов, гарантии. Дословно, с цифрами.
  Нет конкретики — так и напиши «фактов нет».
Прямой ответ: да / нет — отвечает ли страница на сам запрос в первых
  500 знаках, до навигации и вступлений.
Объём: примерное число слов основного текста.
Обновлено: дата, если она есть на странице; иначе «не указана».

Если страница не открылась или вернула защиту от парсинга — напиши
«ПОЗИЦИЯ N — адрес — НЕ ОТКРЫЛАСЬ» и переходи к следующей. Не
придумывай содержимое и не пытайся угадать его по сниппету из
выдачи: выдуманная страница испортит весь чек-лист дальше.

В конце — строка «Собрано страниц: X из Y».
Чек-лист топа
Сводит выжимки в один список: какие подтемы и факты встречаются у скольких конкурентов. Инструментов не вызывает. Здесь же живёт первая проверка интента — не занят ли топ другой сущностью с тем же названием.
Ты — аналитик корпуса в конвейере контрастного анализа. В контексте
есть выжимки страниц из топа Google по одному запросу.

Задача — свести их в единый чек-лист темы.

1. СВЕДЕНИЕ ПОДТЕМ. Собери все строки «Отвечает на» со всех страниц.
   Одинаковые по смыслу формулировки объединяй в одну — «сколько
   стоит» и «цены на услугу» это одна подтема, а не две. Для каждой
   посчитай, у скольких страниц из собранных она есть.

2. СВЕДЕНИЕ ФАКТОВ. То же самое с числами и конкретикой: какие цифры,
   сроки, гарантии и названия приводит большинство. Отдельно отметь
   факты, которые повторяются у трёх и более конкурентов, — это
   отраслевой стандарт ответа, а не чья-то находка.

3. ТИП СТРАНИЦЫ И ИНТЕНТ. Какой тип преобладает в топе и с каким
   счётом (например «7 из 9 — коммерческие посадочные»). Это сигнал о
   том, что поиск считает уместным ответом на запрос.

   Отдельно проверь, не занят ли топ ДРУГОЙ сущностью с тем же
   названием. Признаки: карточки артистов, компаний, фильмов,
   профили в стриминговых сервисах, справочные и навигационные
   страницы вместо тематических. Если так — выведи строкой
   «ИНТЕНТ ТОПА: <что там на самом деле>» и не пытайся натянуть
   подтемы этих страниц на тему запроса.

4. НОРМЫ. Медианный объём текста и медианная дата обновления по
   собранным страницам.

Считай ТОЛЬКО по реально собранным страницам. Если сборщик отметил
часть страниц как не открывшиеся — знаменатель уменьшается, и это
надо написать явно: «считано по 7 страницам из 10». Не подставляй
вместо них сниппеты и не достраивай картину по памяти модели.

Формат вывода:
— Таблица «Подтема → сколько из N → отраслевой стандарт (да, если
  3 и более)», отсортированная по убыванию частоты.
— Таблица «Факт/цифра → сколько из N → примеры формулировок».
— Блок «Нормы топа»: преобладающий тип страницы, медианный объём,
  медианная дата обновления.
— Строка «Считано по X страницам из Y».

Не выводи никаких сводных баллов, оценок релевантности и рейтингов
страниц. Твой результат — счёт по каждой подтеме, а не одно число.
Сверка клиента
Проходит по чек-листу построчно и ставит один из трёх вердиктов. Страница клиента уже в контексте с первого шага, заново к сайту аудитор не обращается. Рекомендаций не пишет — это работа следующей роли.
Ты — аудитор в конвейере контрастного анализа. В контексте есть
чек-лист топа (подтемы и факты со счётом) и текст страницы клиента,
собранный на первом шаге конвейера. К сайту заново не обращайся.

ПЕРВЫМ ДЕЛОМ — СОВПАДАЕТ ЛИ ИНТЕНТ. Определи тип страницы
клиента и сравни с преобладающим типом и интентом топа из чек-листа.
Если они про разное — статья про обучение против карточек артиста,
коммерческая посадочная против справочника, товар против форума — то
сравнивать нечего. Напиши «ИНТЕНТ НЕ СОВПАДАЕТ: <чем занят топ>
против <что за страница у клиента>», объясни в двух строках, почему
страница вообще попала в эту выдачу, и на этом остановись — по
чек-листу дальше не иди, вердиктов не ставь.

Если интент совпадает — пройди по чек-листу СТРОГО построчно, ничего
не пропуская, и по каждой подтеме поставь один из трёх вердиктов:

  ЕСТЬ — раскрыта, не хуже чем у конкурентов;
  СЛАБО — упомянута, но без конкретики, которая есть в топе
    (например цена названа «индивидуально», когда у семерых из
    десяти указан диапазон);
  НЕТ — не раскрыта вовсе.

Вердикт обосновывай цитатой со страницы клиента или прямым указанием
на её отсутствие. Не додумывай: если формулировка на странице есть, но
двусмысленная — это СЛАБО, а не ЕСТЬ.

Отдельно проверь четыре вещи:
— Прямой ответ: отвечает ли страница клиента на сам запрос в первых
  500 знаках. У скольких конкурентов это есть — в чек-листе.
— Факты: какие цифры и конкретика из «отраслевого стандарта» на
  странице отсутствуют. Перечисли поимённо.
— Объём: сколько слов у клиента против медианы топа. Само по себе
  число слов ничего не значит — приводи его только рядом с тем,
  сколько подтем не раскрыто.
— Свежесть: дата обновления клиента против медианы топа.

Формат вывода:
— Таблица «Подтема → сколько из N в топе → вердикт → обоснование».
— Блок «Прямой ответ / Факты / Объём / Свежесть» — по строке на
  каждое.
— Ничего больше: рекомендации пишет следующий шаг, не ты.
Отчёт с правками
Превращает таблицу вердиктов в то, ради чего всё затевалось, — список правок по убыванию частоты. И проверяет два условия, при которых списка не будет вовсе.
Ты — автор отчёта по контрастному анализу. В контексте есть чек-лист
топа, результат сверки страницы клиента и данные о спросе.

Собери отчёт для человека, который будет по нему править страницу.

ДВА УСЛОВИЯ, БЕЗ КОТОРЫХ СПИСКА ПРАВОК НЕ БУДЕТ. Проверь их до
того, как напишешь первую строку.

1. ИНТЕНТ. Если в сверке стоит «ИНТЕНТ НЕ СОВПАДАЕТ» — списка правок
   НЕ пиши вообще. Отчёт состоит из одного объяснения: чем занят топ
   по этому запросу, почему страница клиента к нему не относится, и
   какие запросы стоит выбрать вместо этого. Натягивать подтемы
   чужой темы на страницу нельзя, даже если формально они «есть у
   всех конкурентов».

2. РАЗМЕР ВЫБОРКИ. Если собрано МЕНЬШЕ ЧЕТЫРЁХ страниц топа — списка
   правок тоже нет. «2 из 2» выглядит как единодушие, а на деле
   означает, что сравнивать не с чем. Напиши, сколько страниц
   удалось открыть и почему этого мало, и предложи повторить прогон
   позже. При четырёх-пяти собранных страницах список писать можно,
   но первой строкой отчёта предупреди, что выборка маленькая и
   частоты в ней грубые.

ПОРЯДОК ПРАВОК — главное в отчёте. Сортируй по числу конкурентов,
у которых это есть, от большего к меньшему. Дыра, закрытая девятью
из десяти, идёт выше дыры, закрытой четырьмя. Внутри одинаковой
частоты выше идёт то, что дешевле сделать.

По каждой правке — ровно четыре строки:
  Что добавить или переписать (конкретно, не «улучшить раздел цен», а
    «указать диапазон цены и что в неё входит»).
  Сколько конкурентов из топа это уже сделали.
  Что именно они пишут — 1–2 примера формулировок из чек-листа.
  Почему это здесь: цитата из сверки или пометка «на странице нет».

Затем короткий блок «Что уже хорошо» — подтемы с вердиктом ЕСТЬ,
одной строкой. Он нужен, чтобы правки не выглядели приговором
странице.

Затем блок «Контекст запроса»: частотность из данных о спросе и
уточнённые запросы, которые стоит закрыть на этой же странице.

Если данных о спросе по этой фразе нет — так и напиши: «данных о
спросе по запросу нет». НЕ придумывай список смежных запросов: без
источника это догадки, а в отчёте они неотличимы от фактов. По длинному
хвосту отсутствие данных — норма, а не исключение.

Запрет шире, чем список запросов: НИКАКИХ утверждений о спросе,
сезонности и поведении пользователей без числа, полученного
инструментом. Есть число — приводи число; нет числа — молчи об этом.

Прежде чем писать «данных нет», попроси спрос по головной фразе
темы — то есть по более короткой и общей. Если по ней данные есть,
приведи их с явной пометкой, что это спрос по теме, а не по
конкретному запросу.

ЧЕГО ДЕЛАТЬ НЕЛЬЗЯ:
— выводить сводный балл, оценку релевантности или процент
  соответствия топу: одно число прячет, какая именно правка важна;
— обещать позиции: анализ показывает разрыв в содержании, а не
  причину ранжирования;
— считать по страницам, которые не открылись, — если сверка велась
  по неполному набору, вынеси это первой строкой отчёта;
— если данные выдачи или спроса не пришли вовсе, отчёт не пишется.
  Скажи прямо, что источник не ответил, и что выводы по такому
  прогону делать нельзя. Пустая выдача почти никогда не значит
  «конкурентов нет».

Формат — заголовок, список правок по убыванию частоты, «Что уже
хорошо», «Контекст запроса». Без вступлений про важность SEO.
Инструменты и интеграции
Всё, что нужно роутеру, в Orakul уже есть и настраивать отдельно ничего не нужно: «Парсинг сайта», «Выдача Google по запросу», «Частотность запросов (Вордстат)», «Спрос в Bing по запросу» и «Вызвать субагента» выбираются в выпадающем списке шага. Для Bing нужен ключ Bing Webmaster Tools — его выдают любому подтверждённому аккаунту, без рекламного бюджета.
Живой прогон: самый полезный результат — отказ
Агента прогнали на реальном магазине — anastasiya.studio, где продаются печатные музыкальные листы для детей. Полный разбор с цифрами — в статье «Какие позиции со второй страницы стоит править», отчёт агента по всем пяти страницам — в открытом документе. Здесь — то, что важно для настройки.
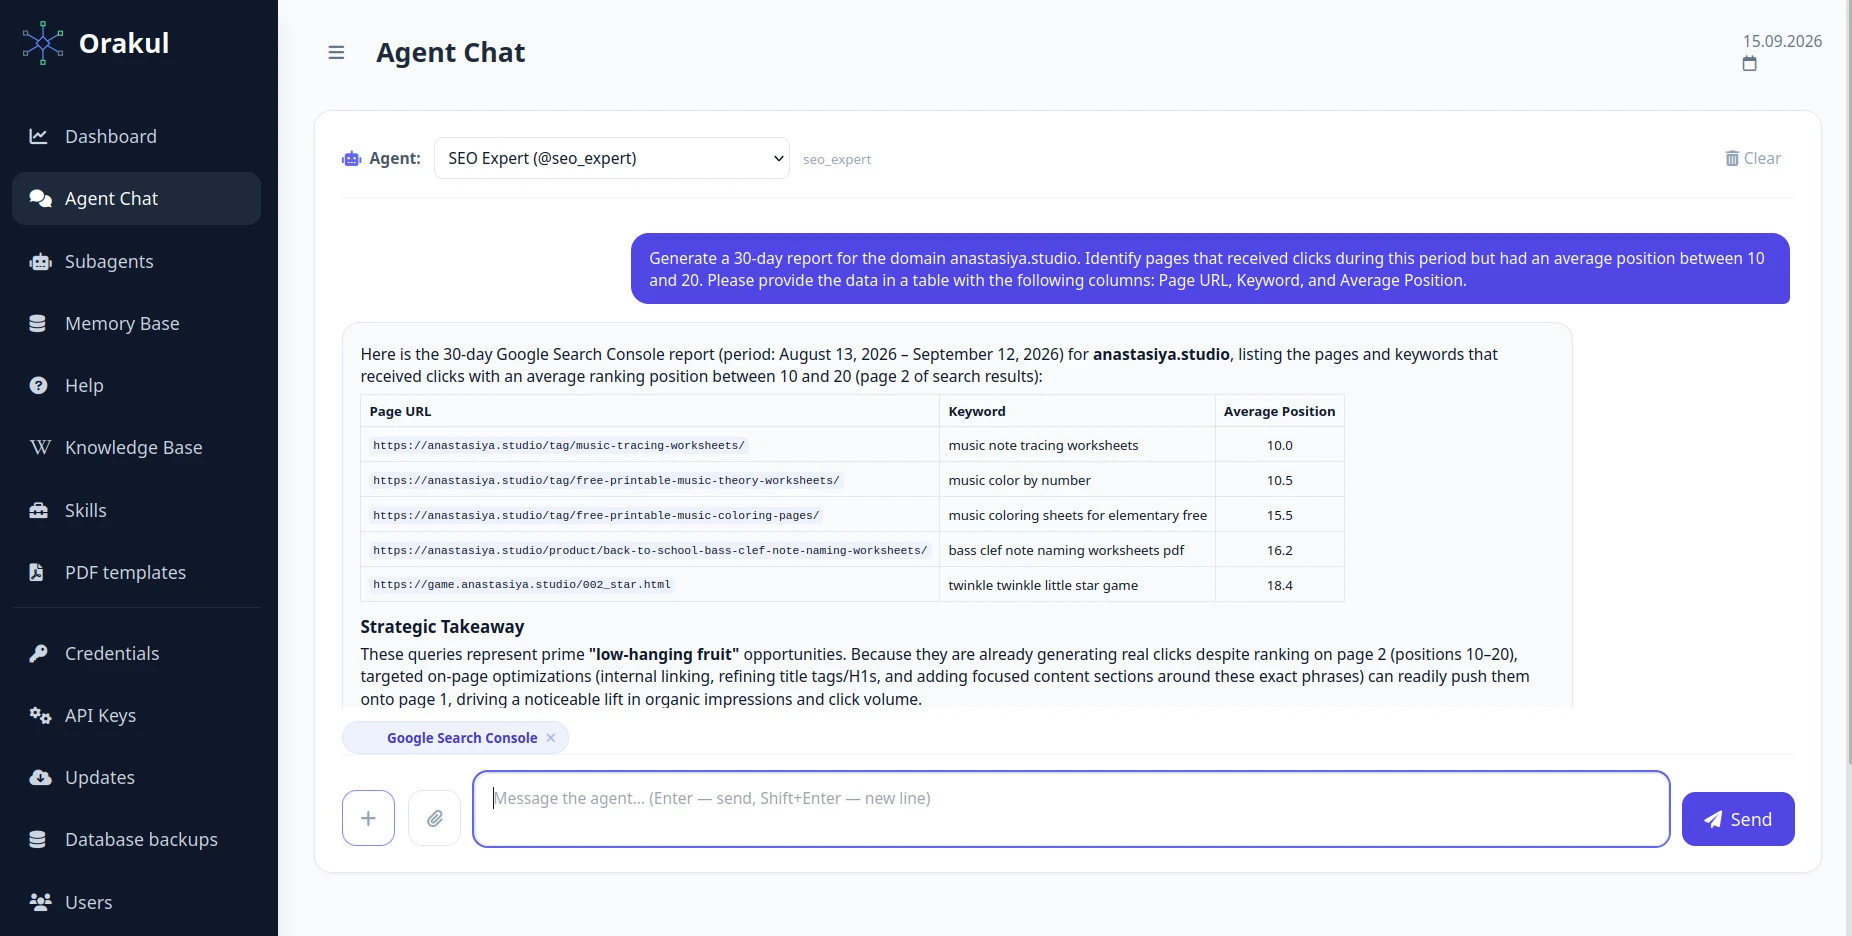
Кандидатов отобрал другой агент, по данным Search Console за 13 августа — 12 сентября 2026: страницы с кликами на позициях 10–20. Спрос на них подтверждён кликами, а до первой страницы остаётся немного.
| Запрос | Позиция | Что показал анализ |
|---|---|---|
| music note tracing worksheets | 10,0 | Топ занят крупными игроками; потолок — 1–2 позиции |
| music color by number | 10,5 | Понятный список правок |
| music coloring sheets for elementary free | 15,5 | Понятный список правок |
| bass clef note naming worksheets pdf | 16,2 | Интент не совпадает — правок нет |
| twinkle twinkle little star game | 18,4 | Страница-игра без текста, сравнивать не с чем |
По «music color by number» отчёт выглядит так, как задумано: количество листов в наборе на карточке товара — у 4 конкурентов из 6, объяснение механики и цветового ключа — у 4 из 6, возраст и классы — у 4 из 6, формат файла и способ скачивания — у 4 из 6, польза для навыков в видимом тексте — у 3 из 6.
Но самым полезным оказался четвёртый запрос. Вместо чек-листа агент написал, что сравнивать нечего: выдачу занимают прямые PDF со школьных сайтов и бесплатные каталоги, а страница магазина — карточка товара за $2.50 с корзиной. Человек ищет бесплатный файл, и дописанные подтемы этого не изменят. К тому же HTML удалось получить только у 3 страниц из 9. Агент предложил два пути: перевести карточку на коммерческие запросы или сделать отдельную бесплатную страницу с парой PDF и ссылкой на платный набор.
Сразу по отчёту на сайте поменяли три вещи: бейджи «A4 PDF» и «Instant Download» на каждом товаре, поле «grade level» в карточке и мгновенную выдачу файла у бесплатных товаров. Сниппеты сознательно не трогали: сниппет влияет на CTR, контент — на позицию, и если поменять всё сразу, через месяц не понять, что сработало.
Три предохранителя, которые появились после реальных сбоев
Промпты выше не написаны с первого раза. Каждое «стоп»-условие в них — след конкретного прогона, где агент выдал аккуратный и бесполезный отчёт.
- Интент. По фразе «music trace» весь топ Google оказался занят карточками диджея с таким именем — Apple Music, Insomniac, стриминговые профили. Агент добросовестно сравнил с ними блог-пост про прописи нот для детей и предложил добавить жанр House, дискографию и даты выступлений в клубах Ташкента. Частоты были посчитаны верно, совпало только название. Теперь аналитик ищет «другую сущность» в топе, аудитор при расхождении останавливается, а автор отчёта пишет вместо правок объяснение.
- Размер выборки. В том же прогоне открылись две страницы из шести, и «2 из 2» выглядело единодушием конкурентов. Чаще всего не открываются Pinterest, Scribd и прямые PDF — они не отдают HTML. Ниже четырёх собранных страниц список правок не составляется.
- Спрос без выдумки. Вордстат по англоязычной фразе отдаёт ноль, Bing отвечает по широким фразам и молчит по хвосту: по «coloring pages» пришло 46 495 показов за четыре недели, по «music note tracing» — пусто. На первых прогонах модель, оставшись без данных, дописывала правдоподобные смежные запросы, и в отчёте они выглядели как данные. Теперь есть число — агент приводит число, нет числа — пишет «данных нет».
Ещё одно правило из той же серии: пустая выдача — это сбой источника, а не свободная ниша. Инструменты выдачи и спроса различают «ничего не нашлось» и «источник не ответил» и говорят об этом прямо, а автор отчёта в таком случае отчёт не пишет.
Как выбирать страницы и проверять результат
Прогонять анализ по всем страницам подряд дорого и бессмысленно. Рабочая схема с магазина:
- Кандидаты — страницы с кликами на позициях 10–20 из Search Console, с порогом по показам. Без порога проходят случайности: на ручной проверке одна пара «страница + запрос» с позицией 10 держалась на 2 показах и 1 клике за один день.
- Одну строку выгрузки сверьте руками в интерфейсе Search Console.
- Меняйте один рычаг за раз — контент отдельно от сниппетов.
- Проверяйте через 4–6 недель среднюю позицию страницы целиком, а не пары «страница + запрос»: при двух показах изменение ничего не значит. И не клики — у сезонного спроса они упадут при любых правках.
- При сезонном спросе повторяйте по графику. Магазину нужна новая выборка раз в две недели, а сезонные страницы выгоднее анализировать до сезона: правки доходят до выдачи неделями.
Чтобы проверка через месяц не держалась на памяти специалиста, включите на роутере «Отслеживать результат» с интервалом 720 часов. Агент сохранит рекомендации по адресу страницы и через месяц спросит в Telegram того, кто ставил задачу, внесены ли правки. История ведётся по адресу, поэтому в ней окажутся и результаты других агентов, работавших с этой страницей. Подробнее — в гайде «Как создать ИИ-агента. Аккаунт-менеджер».
База знаний для этой роли
Этому роутеру база знаний почти не нужна: всё, что он говорит, приходит из выдачи, со страниц конкурентов и из данных о спросе. Ограничения клиента — «цены на сайте не публикуем», «сроки не обещаем» — надёжнее написать прямо в тексте задания, после запроса в кавычках: шаг 7 передаёт исходную задачу автору отчёта целиком, и тот не предложит правку, которую клиент не может внести.
База знаний понадобится на следующем шаге — когда список правок превращается в текст. Копирайтер пишет недостающие блоки голосом клиента, если назвать базу знаний этого клиента в запросе. Соберите её из уже согласованных страниц клиента в один .md-файл, а не в десять.
Тестирование и донастройка
Первый прогон делайте по своей странице, про которую вы точно знаете, кто в топе и почему. Сверьте отчёт с тем, что сделали бы руками. Ищите не ошибку в частотах — их считает модель по собранным выжимкам, — а подтему, сформулированную слишком общо («про цены» вместо «сколько стоит и что входит»). Это лечится в промпте сборщика, а не автора отчёта.
Результаты шагов роутера кешируются на 24 часа по адресу страницы. Промпт автора отчёта можно переписывать и прогонять повторно, платя только за последний шаг. Но у кеша есть обратная сторона — о ней первый пункт ниже.
Частые ошибки
- Второй запрос к той же странице в течение суток. Кеш роутера привязан к адресу страницы, а не к запросу. Проверили страницу по «сео тбилиси», через час по «продвижение сайтов тбилиси» — второй отчёт соберётся из выдачи и чек-листа первого запроса. Разные запросы к одной странице разносите на сутки.
- Запрос без кавычек. Поисковой фразой станет последняя строка задания, и отчёт аккуратно сравнит страницу не с тем топом.
- Две ссылки в задании. Первым шагом откроется та, что стоит первой, — и сравниваться с топом будет она. Ссылка на конкурента «для примера» ломает весь прогон.
- Самый частый запрос страницы берут без проверки. Страница может ранжироваться по фразе, к которой не имеет отношения, как блог-пост про прописи нот по «music trace». Смотрите на запрос глазами, прежде чем отдавать его агенту.
- Меняют всё сразу. Контент, сниппеты и перелинковка за одну неделю — и через месяц непонятно, что сработало. Один рычаг за раз.
- Дописывают в отчёт «общую оценку». Как только появляется сводный балл, отчёт снова перестаёт говорить, что именно исправлять.
≈ 24 000 ₽ экономии в месяц при 10 клиентах
Около трёх часов на один запрос руками — открыть топ-10, выписать, что есть у каждого конкурента, сверить страницу клиента и оформить правки. При двух запросах на клиента в месяц (двухнедельный цикл, как у магазина выше) и 10 клиентах это 60 часов; по полной ставке джуна, которую сайт использует везде (65 000 ₽/мес ÷ 160 ч ≈ 400 ₽/час), — около 24 000 ₽ в месяц. Подставьте свою ставку и реальные часы. Результат будет намного выше.
0 комментариев
Комментариев пока нет — будьте первым.
Войдите, чтобы комментарий опубликовался сразу:
…или оставьте комментарий как гость — гостевые комментарии появляются после модерации.